 TalkTuck
Apple Watch 全天候录音方案,我淦出来了
本文记录当时的实现思路和有限测试,功能与版本可能已变化;长时间录音的可靠性仍需实际验证。
手表录音,传给手机,手机再转成文字。我很快就跑通了第一版 Demo,真正费功夫的是把它打磨好。
最近,我给自己做的录音 App TalkTuck 加上了 Apple Watch 这一端。
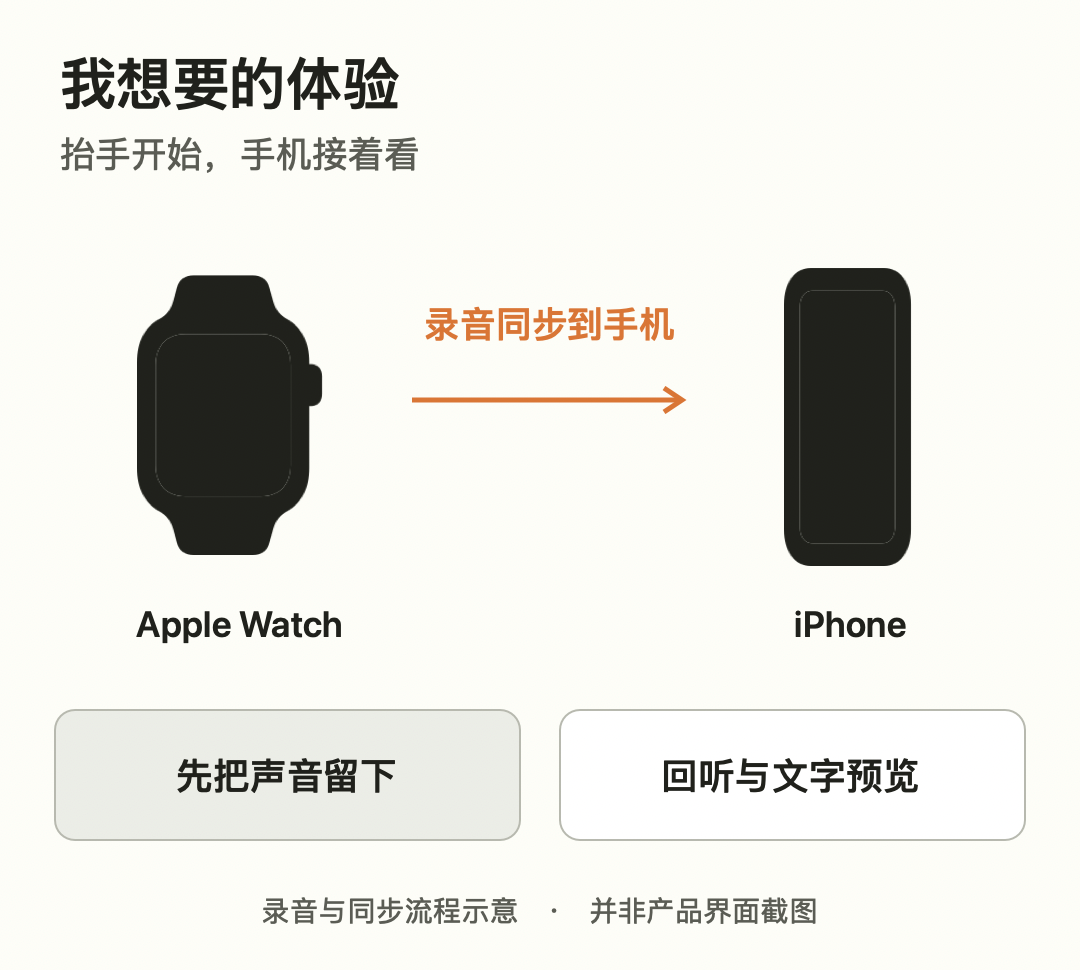
我想要的体验很简单:在手腕上开始录音,手机能陆续收到内容、显示文字。连接断了一会儿,手表接着录;等条件恢复,再把缺的内容补过去。
第一版 Demo 很快就跑通了:手表能录,手机能收,也能转出文字。那时很容易觉得,这个功能已经差不多做出来了。
可真正开始打磨,问题才陆续冒出来。尤其是把录音拉长、把手腕放下,或者让连接中断以后,原本顺畅的演示就不够用了。
手表录了两分钟,手机怎么才更新到一分钟?手机收到声音了,文字怎么还停在前面?如果放下手腕、临时断连,这段录音最后还能不能完整留下?
后来,我把这件事拆成了三个目标:录音要可靠,传输要稳定,转出来的文字要能接着用。这篇主要聊我在这三个目标上做了哪些选择,以及为什么这样选。
录音:看似简单,却是数据同步的基础
录音看起来只是按下一个按钮,但后面传输和识别依赖的,都是已经保存下来的音频。如果分段不清楚、时间对不上,就很难判断到底是没录到,还是没传到。所以,我先把录音当作整条数据同步链路的基础来做。
我定下的优先级是:先录下来,再传过去,最后整理成文字。
如果录音必须等手机在线才能继续,使用它的人就得一直惦记连接状态。所以,我让手表先把声音保存在本地,再一小段一小段交给手机。
实现上,每个片段都有录音 ID、序号、起始位置和有效音频帧数。已经封存的片段不再修改,本地恢复记录和待传队列分别保存进度。手机暂时收不到,手表仍然可以继续保存后面的声音。
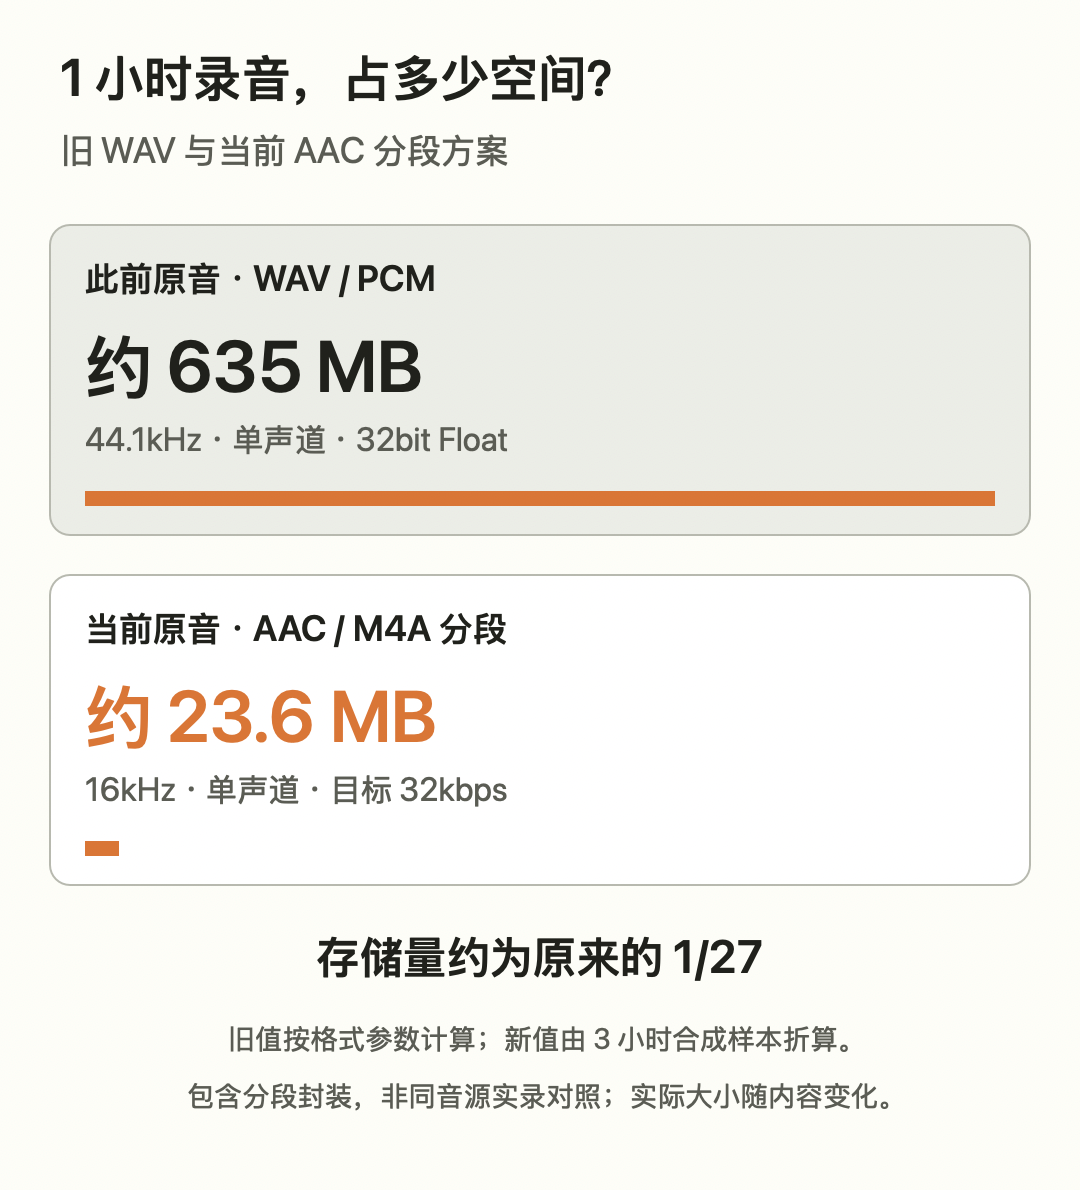
格式上也做了取舍。早期录音文件偏大,保存和传输都更吃力。我把新录音统一成 16kHz、单声道、目标码率 32kbps 的 AAC,按 10 秒分段封存为 M4A 文件。AAC 是音频编码,M4A 是文件封装;同一份片段用于保存、同步和本地预览,减少中间反复转换的工作。
拿 1 小时录音来对比更直观:旧的 44.1kHz、单声道、32bit Float WAV,音频数据约 635MB;现在这套 AAC 分段方案,按已有测试样本折算约 23.6MB,约为原来的 1/27。这个变化直接减轻了手表存储和后续传输的负担。
录音结束时,我再生成一份最终清单,列出这条录音应该有哪些片段。每段还带一个 SHA-256 校验值,相当于文件内容的指纹。这样,手机能检查缺段、内容损坏和时间不连续,不能只看播放器上显示了几分钟。
原始片段也会继续保留。文字可以修改,识别方式以后可能变化,我得给自己留一条回到声音本身的路。
代价是需要占用存储空间。这个成本我愿意先承担:空间占用可以继续管理,一段没有留下来的声音,却不能靠后面的识别再补回来。
传输:我遇到情况最多的一环
传输是这次遇到情况最多的一环。设备配对着,不代表应用的即时通道可用;前台能传,不代表后台会马上送达;文件交给系统,也不代表手机已经完整保存。
再加上息屏、断连、进程重启和重复到达,同一段音频可能从不同路径抵达。我需要同时安排好快传、后台交接、失败后的恢复,以及手机端的确认和去重。
底层我用的是 Apple 的 WatchConnectivity。正在手机上看预览、即时通道可用时,优先通过 sendMessage 快传;平时没有盯着手机,就把原始片段打包,通过 transferFile 交给系统后台队列。默认按约 60 秒内容积攒一批,结束录音等事件可以提前提交。
有个很具体的坑:我原先把快传阈值设为 48KB,但实机上一个 10 秒 M4A 片段就有约 65KB,超过阈值后没走预期的快传路径。后来我把适合快传的片段拆成最多 32KiB 的小块发送,消息失败或超时再回退到文件传输。48KB 是我当时代码里的阈值,不是苹果规定的通用上限。
连接中断时,未确认的片段留在手表的持久队列。手机把收到的片段落盘,核对序号、大小和 SHA-256,再返回确认;重复到达的片段去重,缺少的继续补传。结束后还要核对最终清单、保存录音索引,才算整条录音完整送达。
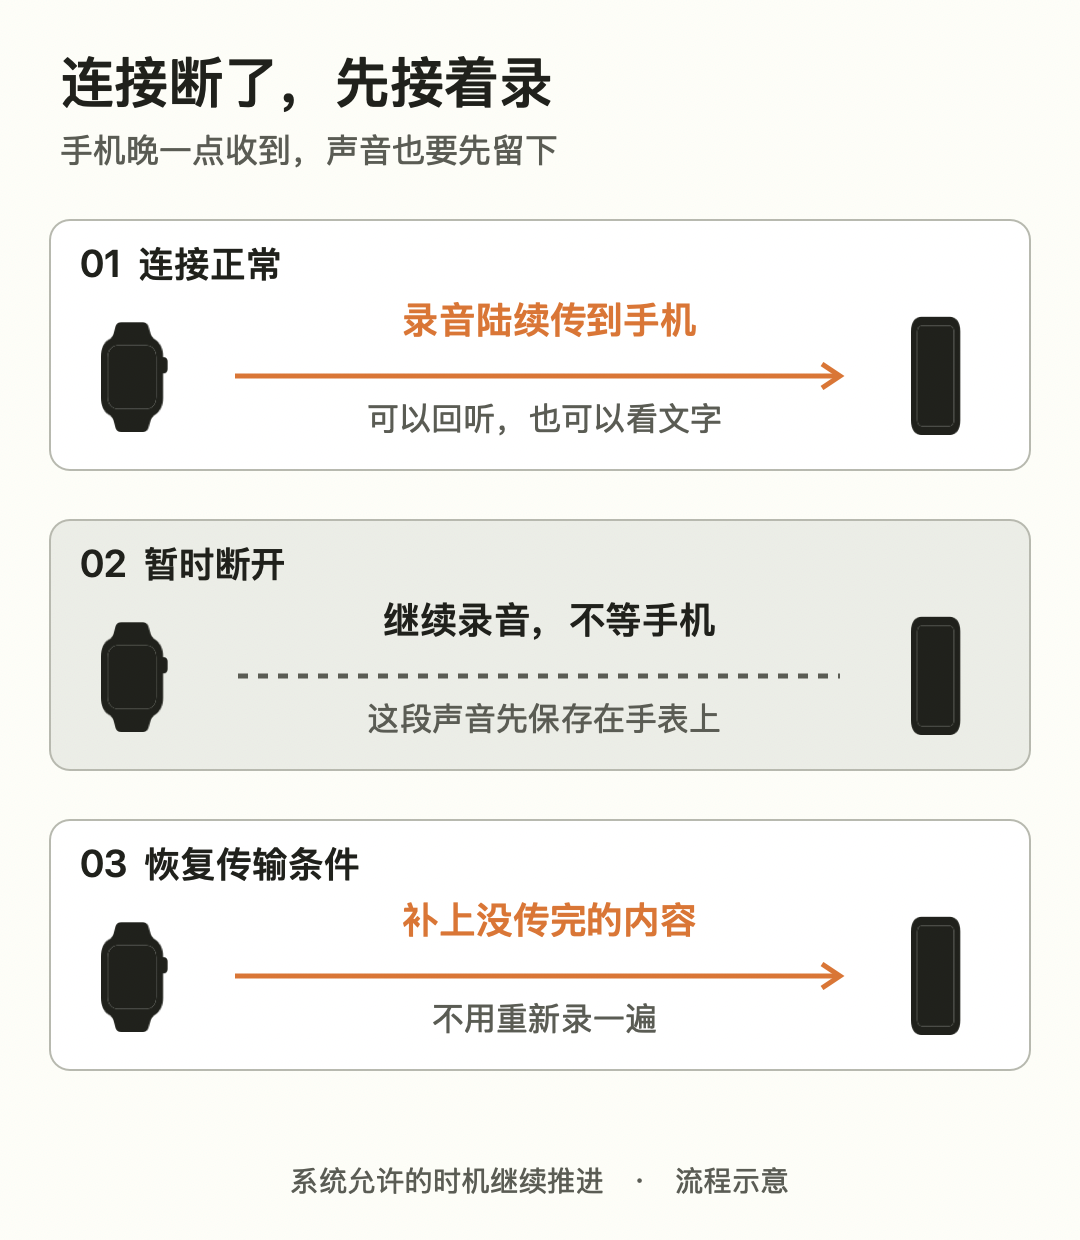
这里我接受了一个代价:后台内容可能晚一点到。我不再要求手机上的数字每一秒都追平手表,而是优先把保存、恢复和完整接收做好。
这样的设计也减少了对频繁来回通信、持续点亮屏幕的依赖。不过,到底能省多少电,还得靠实际测量,不能从设计直接推导出续航成绩。
一轮手动断连复测中,121.2 秒录音最终形成 13 个片段,手机与手表的原音逐段字节及 SHA-256 一致,时间线也连续;手机回放里能听到断连期间的话。这是一次短录音验证的结果,长期使用还要继续测。
转录:在手机上离线处理,让文字跟上录音
声音到了手机,我想先让它在本机变成文字。离线识别能力和所需模型准备好后,转录本身不依赖互联网;手表到手机的传输,则继续走两台设备之间的连接。
录制中的“实时”预览,跟随到达手机的片段增量更新,不要求每句话立即定稿。我先在这一阶段碰到了一个问题:同一条 121.2 秒录音,原音已经完整收到,本地预览却停在前 30 秒。片段边界上的文字还没最终确认,原来的状态判断就把它当成超时失败,后续处理被卡住了。
我的第一个选择,是把接收队列和识别进度分开。本地保存“已经处理到哪里”,按已收到的片段增量识别。同时修掉接收端反复重建整段音频的工作,避免每多来一段,又把前面全部处理一遍。
第二个选择,是允许本地预览保留临时结果,再继续处理后面的片段;恢复时保留已完成文本和进度。修复后,这条录音的预览处理范围从 30 秒推进到了完整的 121.2 秒,前面已有的文字也保留下来。但其中仍有两行临时结果,我没有把它们当作全部定稿。
录音结束,也不意味着文字在那一秒就全部完成。手机还要接收剩余片段、处理尚未识别的内容。因此,我把“原音已完整收到”“文字处理到了哪里”“结果是否定稿”分别记录和显示,避免一个“完成”状态把三件事混在一起。
目前验证到的是,本地预览能够保留已有内容,并把这条短录音的处理进度补到结尾;这还不能等同于整篇文字都已校正。对仍有疑问的地方,原音始终留着,可以回听核对。
这里改善的首先是离线转录的可用性:文字能否继续更新,进度能否接上,临时结果会不会让后面的内容停住。
至于识别准确率有没有提高,我还没有足够的同批录音对比数据。把处理流程接顺,解决的是漏处理和卡住的问题;转出来的每个字是否准确,还得单独验证。
我淦通了基础方案,全天候还要实测
回头看,这次真正花时间的,是把三个目标的顺序排清楚:录音先可靠留下,传输在连接变化后还能恢复,转录再把收到的内容逐步变成可用的文字。
有些地方我选择保留原音,有些地方接受内容晚一点到,有些地方允许文字暂时不定稿。这些选择都有成本,但它们让基础流程有了更清楚的边界。
为了检查长录音,我还用合成音频跑了 12 小时规模的测试:录音内核生成并校验了 4320 个独立片段,第 6 小时模拟重启后,录音位置能准确接上。另一次 12 小时规模的传输测试加入断连、重启和确认丢失,最终文件校验一致。这些结果验证了长音频的数据处理与恢复,还不是 12 小时连续离线转录,也不是手表连续戴着录满 12 小时的续航成绩。
真机上已经验证的是短录音同步、本地预览、手动断连后的补传与回放。接下来,要把实际录制时间拉长,分别测续航、息屏同步和长时间离线识别的表现。
第一版 Demo 很快就有了,后面的时间花在了这些可靠性和体验问题上。这篇记录的,就是我打磨它时做出的选择。等整天实录和耗电数据出来,再写下一篇。